ИИ-детектор текста КонтрПлагиат, версия антиплагиат ВУЗ, 2.0
ИИ-детектор текста «КонтрПлагиат ВУЗ 2.0»
ИИ-детектор «КонтрПлагиат», версия антиплагиат ВУЗ 2.0, предназначен для предварительной проверки русскоязычных академических материалов на статистические и стилометрические признаки генеративного происхождения. Пользователь получает воспроизводимый числовой прогноз, подробные значения основных показателей и маркировку конкретных проблемных фрагментов. Методика предназначена для предварительной диагностики текста перед его последующей содержательной и академической проверкой.
Назначение ИИ-детектора
«КонтрПлагиат» представляет собой сервис инструментов для авторов академических работ. Один из его компонентов выполняет предварительный поиск статистических и стилометрических признаков генеративного происхождения в академических текстах. Калибровочные выборки включали тексты GPT и Claude разных версий. Отдельные тематические сегменты формировались с помощью Gemini и Grok по сопоставимым заданиям. Дополнительные испытания охватывали материалы Llama и DeepSeek на русском языке. Контрольные наборы включали результаты Qwen и Kimi по тем же предметным направлениям. На отдельных этапах также проверялись GLM, GigaChat и YandexGPT.
Детектор ориентирован прежде всего на связные русскоязычные академические тексты достаточного объёма из гуманитарных и прикладных научных областей с характерной для диссертационных работ структурой изложения. Основная задача алгоритма состоит в расчёте воспроизводимого статистического прогноза по совокупности измеряемых характеристик русскоязычного текста. Пользователь получает подробные числовые показатели по каждому основному признаку и видит отмеченные проблемные фрагменты непосредственно в исходной последовательности предложений анализируемого академического материала. После ручного или машинного редактирования он может сразу выполнить повторный расчёт на неизменных настройках.
Экспертная и публикационная основа методики
Разработка методики связана с многолетней практической работой Вячеслава Алексеевича Мустакимова в области академического редактирования, проверки оригинальности и применения искусственного интеллекта при подготовке исследовательских материалов. Профессиональный опыт автора и разработчика составляет более 30 лет. Предметная специализация подтверждается многочисленными книгами, практическими пособиями и монографиями, посвящёнными академическому письму, технологии «КонтрПлагиат», промпт-инжинирингу и применению языковых моделей в исследованиях.
Авторские издания опубликованы в России, имеют индивидуальные ISBN и представлены в каталогах книжных сервисов. Книги распространяются более чем через 500 торговых и цифровых площадок. Такая публикационная представленность обеспечивает открытость авторства и позволяет независимо проверить библиографические сведения. Достоверность числовых результатов самого детектора определяется отдельно: составом размеченных корпусов, порядком разделения данных, независимыми тестовыми прогонами и сформированными матрицами ошибок.
Корпуса и порядок калибровки
Академическая референтная база включала более 10 млн абзацев российских диссертационных работ, написанных до 2020 года. На материале этого корпуса изучались устойчивые свойства научного изложения в диссертациях разных специальностей и определялись ориентиры для авторского класса. Обучение классификатора проводилось на отдельных размеченных наборах человеческих и генеративных материалов. Итоговая проверка выполнялась на данных без прямого пересечения с обучающей частью.
На одном из основных этапов калибровки была обработана выборка из 351 580 размеченных текстов. После удаления технически некорректных записей в итоговый расчёт вошло 351 570 полноценных материалов с сохранённой классовой разметкой. Человеческий класс включал 87 680 текстов, написанных людьми. Генеративная часть содержала 88 010 текстов GPT-4 Turbo и 87 980 материалов Llama 3.3 70B. Ещё 87 900 примеров были сформированы с помощью Gemma 2 27B.
Основной размеченный корпус разделялся на обучающую и валидационную части с сохранением классовых пропорций и контролем тематической обособленности материалов внутри каждого сформированного сегмента. Независимый тестовый массив формировался отдельно по заранее установленным правилам. Итоговое соотношение обучающей и валидационной частей с независимым тестом составляло 60/20/20. Дополнительно выполнялась пятикратная групповая проверка по десяти тематическим сегментам. Такой порядок позволял оценить устойчивость классификации на материалах разной предметной направленности. Одновременно проверялась переносимость решения на предметно обособленные материалы без опоры на случайное перемешивание фрагментов внутри одной совокупности.
На следующем этапе объём калибровочной базы был увеличен до 2 379 290 записей. После применения минимального ограничения по объёму осталось 2 137 760 текстов. К генеративному классу относились 1 306 230 материалов достаточного объёма из нескольких модельных семейств с различающимися параметрами построения ответа. Человеческий класс включал 831 530 текстов диссертационного уровня (10 млн. абзацев). Независимая тестовая часть содержала 471 720 примеров достаточного объёма с сохранёнными тематическими идентификаторами. Пересечение между обучающей и тестовой выборками по тематическому идентификатору topic_id отсутствовало.
Отдельный последовательный прогон выполнялся на русскоязычном корпусе test, ru с заранее сохранённым порядком всех исходных записей. Общий последовательный массив включал 525 210 материалов из русскоязычной контрольной выборки. Условиям проверки соответствовали 469 650 текстов достаточного объёма с сохранённой исходной разметкой. Ещё 55 560 примеров содержали менее 20 слов и были исключены по единому техническому правилу. Обе сравниваемые версии детектора автоматически отклонили короткие фрагменты до начала статистической классификации. Все подходящие тексты обрабатывались последовательно от первой записи до последнего доступного материала без ручного отбора удобных примеров. Выборочное исключение результатов не применялось [ Мустакимов В. А. , Мустакимов А. В. , , КонтрПлагиат методом перефразирования и рерайта для антиплагиат ВУЗ , ISBN 978-5-0064-3068-6 ].
Метрики и результаты испытаний
При оценке модели рассчитывались общая Accuracy и устойчивая к дисбалансу классов Balanced Accuracy. Для каждого класса отдельно определялись Precision и Recall с последующим сопоставлением достоверности положительного решения и полноты обнаружения материалов соответствующего происхождения. Дополнительно рассчитывалась ROC AUC и формировалась полная матрица ошибок по каждому независимому прогону. Результаты сопоставлялись между генеративными моделями. Тематические сегменты анализировались раздельно.
В разных независимых испытаниях общая точность составляла от 74,85 до 84,49 %. Различия были связаны с объёмом корпуса и составом генераторов. Влияние также оказывала жёсткость разделения данных. Расширенный прогон на увеличенной независимой выборке показал Balanced Accuracy на уровне 75,36 %. Значение ROC AUC для того же испытания составило 0,832. Другой независимый тест с иным составом корпуса показал Balanced Accuracy на уровне 86,16 %. После калибровки ROC AUC повысилась с 0,889 до 0,941.
Precision генеративного класса в одном из контрольных прогонов составила 95,96 %. После установления порога уверенности на уровне 75 % показатель Precision генеративного класса достиг 98,04 %. Одновременно Recall снизилась до 66,34 %, поскольку модель стала заметно реже выносить категоричное положительное решение по пограничным и внутренне неоднородным академическим материалам. Поэтому значение свыше 97 % относится к высокоуверенным положительным вердиктам. Оно не является общей точностью классификации всех поступивших текстов.
При том же пороге доля ложных срабатываний на человеческих материалах снизилась до 3,99 %. Этот риск учитывается отдельно. Для академического сервиса ошибочное признание авторского текста генеративным имеет самостоятельное практическое значение.
GPT применялся только как вспомогательный инструмент при содержательном разборе отдельных спорных примеров после основного расчёта. Полученные ответы помогали интерпретировать отдельные стилометрические сочетания в пограничных примерах с противоречивыми значениями нескольких входных показателей. Исходную разметку корпуса и статистические результаты такой анализ не заменял. Окончательные пороги закреплялись только после повторных прогонов на независимых данных.
Режим «КонтрПлагиат ВУЗ 2.0»
Для анализа материалов, которые затем загружаются в систему «Антиплагиат.ВУЗ», было изучено более 10 тыс. отчётов данного сервиса. В исследованной выборке определялись признаки, статистически связанные с появлением заключения «Есть подозрения на следующие группы маскировки заимствований — сгенерированный текст». Полученные зависимости используются как эмпирические диагностические ориентиры. Они не раскрывают внутренний алгоритм стороннего сервиса и не рассматриваются как описание его программных правил.
Режим «КонтрПлагиат ВУЗ 2.0» объединяет статистическую оценку с приоритетными диагностическими правилами. Приоритетные правила активируются только после установки пользователем соответствующей галочки в интерфейсе проверки. При обычной проверке итоговый прогноз рассчитывает базовая статистическая и стилометрическая модель без применения специальных правил сопоставления.
В специальном режиме, Антиплагиат ВУЗ 2.0, отдельно выявляются соседние фразы с дельтой 0 или 1. Алгоритм определяет циклические структуры ABA и ABCA по последовательности длин соседних предложений. Дополнительно отмечаются серии предложений, которые длительное время сохраняют значение |Δ| не выше 10. Каждый такой участок выводится на графике. Отметка связывается с конкретным предложением исходного текста [ Мустакимов В. А. , , GPT студентам. 580 промптов, способных решить любую проблему , ISBN 978-5-0060-4647-4 ].
Предварительная обработка текста учитывает квадратные библиографические ссылки и прямые цитаты в составе русскоязычного академического материала. Отдельно распознаются упоминания авторов в формате «И.О. Фамилия». При подсчёте слов инициалы с фамилией рассматриваются как единая конструкция. Квадратные ссылки исключаются из подсчёта слов и расчёта длины фраз.
Минимальный допустимый объём анализа составляет три законченных предложения и не менее 20 учитываемых слов. Короткий фрагмент не обеспечивает достаточной статистической устойчивости для одновременного расчёта нескольких показателей, поэтому интерфейс сообщает об ограничении ещё до формирования итогового прогноза.
Практическая статистика и ограничения
По внутренней ретроспективной статистике, накопленной за пять лет работы сервиса с генеративным контекстом, 97,44 % обработанных материалов проходили последующую проверку в системах «Антиплагиат.ВУЗ» и «РуконтТекст» с первого раза. Этот показатель описывает практический результат предварительной обработки академических материалов. Он не заменяет оценку точности самого классификатора на независимой тестовой выборке с заранее сохранённой разметкой и неизменным порядком обработки всех подходящих документов.
Значение 97,44 % не означает гарантированного исхода для каждого нового документа. Версии сторонних систем могут обновляться, а их критерии способны изменяться. По этой причине практические соответствия периодически проверяются повторными контрольными прогонами.
Принцип визуального анализа
На рисунке 1 показан один из принципов работы ИИ-детектора в режиме «КонтрПлагиат ВУЗ 2.0». Оранжевый график отражает последовательную динамику дельты между фразами и предложениями, которая чаще встречалась в генеративных материалах исследованной контрольной выборки. Синий график соответствует примеру авторского текста из контрольного человеческого класса. Визуализация показывает, как изменяется дельта между соседними предложениями и фразами.

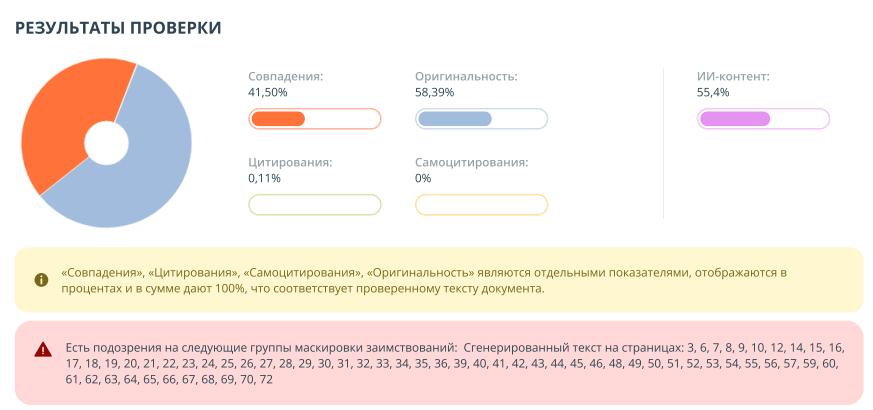
Рисунок 1 — Генеративный текст часто имеет малую дельту между соседними предложениями и фразами, тогда как авторский материал обычно показывает более высокое и менее предсказуемое изменение показателя
Статистическая часть детектора рассчитывает 33 входных параметра для каждого текста достаточного объёма. 27 характеристик описывают свойства текста, ещё шесть учитывают его объём. В число анализируемых показателей входят лексическое разнообразие и распределение длины слов. Отдельно исследуются повторные n-граммы и пунктуационные структуры.
Перед классификацией часть показателей проходит логарифмическое преобразование и стандартизацию. Вероятностная оценка рассчитывается с помощью логистической регрессии с L2-регуляризацией. Такой подход обеспечивает воспроизводимость результата в пределах одной версии алгоритма. Влияние каждого входного признака можно анализировать отдельно [ Мустакимов В. А. , , GPT экономистам. 550 промптов, повышающих производительность в 1000 раз , ISBN 978-5-0060-4146-2 ].
Особенность ИИ-детектора «КонтрПлагиат» в версии «КонтрПлагиат ВУЗ 2.0» состоит в использовании фиксированных расчётных формул. Повторная проверка неизменённого текста в пределах одной версии алгоритма выдаёт одинаковые числовые показатели. Итоговый показатель не формируется свободным ответом модели и не зависит от случайной генерации формулировок. Случайное изменение оценки при сохранении текста и настроек исключается.
Воспроизводимость собственного расчёта не означает постоянного совпадения со всеми сторонними детекторами. Алгоритмы систем «Антиплагиат.ВУЗ», «РуконтТекст», Turnitin, Copyleaks, GPTZero, Originality.ai, Winston AI, Pangram, ZeroGPT динамичны и могут обновляться. Поэтому практическая совместимость периодически проверяется на новых контрольных наборах после заметных обновлений сторонних систем.
GigaCheck от Сбера применялся как один из внешних инструментов контрольного сопоставления. Заключение GigaCheck не использовалось как единственное доказательство правильности внутренней классификации (ГигаЧек не равен Антиплагиат РУ, ВУЗ). Основой оценки оставались размеченные корпуса и независимые тестовые выборки. Дополнительным основанием служила собственная матрица ошибок.
Интерфейсы других решений изучались в ходе отдельного функционального сравнения способов визуализации результата и объяснения причин итогового вердикта. Отдельно рассматривались Copyleaks и GPTZero. Затем анализировались Originality.ai и Winston AI. Функциональное сравнение касалось способов представления результата и доступности объяснений для пользователя. Такое сопоставление не означает совпадения внутренних алгоритмов перечисленных сервисов. Полученные для одного решения пороги нельзя переносить на другой детектор без независимого тестирования на одинаковом русскоязычном корпусе академических текстов.
Порядок проверки текста
Детектор выполняет обычный анализ и специальную проверку для системы «Антиплагиат.ВУЗ». Второй режим включается галочкой «КонтрПлагиат ВУЗ 2.0». Расположение соответствующего элемента интерфейса показано на рисунке 2 вместе с основным окном ввода текста и кнопкой запуска выбранного пользователем режима анализа. Для начала работы пользователь вставляет подготовленный академический материал в основное окно интерфейса. Затем он выбирает требуемый режим проверки и нажимает кнопку «Проверить текст».

Рисунок 2 — Выбор режима проверки текста
Итог проверки включает прогноз вероятности генеративности и интерактивный график изменения показателей по последовательности предложений. На графике отмечаются конкретные предложения с признаками сильного влияния на итоговый прогноз. После нажатия на точку графика, показанную на рисунке 3, пользователь переходит к соответствующему участку текста. В окне правки указывается причина срабатывания. Рядом приводится адресная рекомендация по устранению обнаруженного признака без произвольного изменения остальных частей исходного документа.

Рисунок 3 — Оценка генеративности и график изменения дельты следующего предложения относительно предыдущего
Итоговая вероятность сопровождается набором измеренных показателей и кратким объяснением обнаруженных отклонений. Сервис выводит количество слов в каждом предложении и значение |Δ|. Отдельно показывается коэффициент вариации длины предложений. Пользователь также видит среднюю дельту. Ниже приводятся результаты анализа стилометрических признаков.
Интерактивный график программно связан с таблицей всех проанализированных предложений исходного материала. Красные точки обозначают Δ = 0 или Δ = 1. Синие отметки показывают циклические последовательности ABA и ABCA в динамике длины соседних предложений или выделенных фраз. Оранжевая линия выделяет продолжительную серию предложений, которая остаётся в узком коридоре дельты [ Мустакимов В. А. , , GPT педагогам. 350 промптов, повышающих производительность в 1000 раз , ISBN 978-5-0060-4520-0 ].

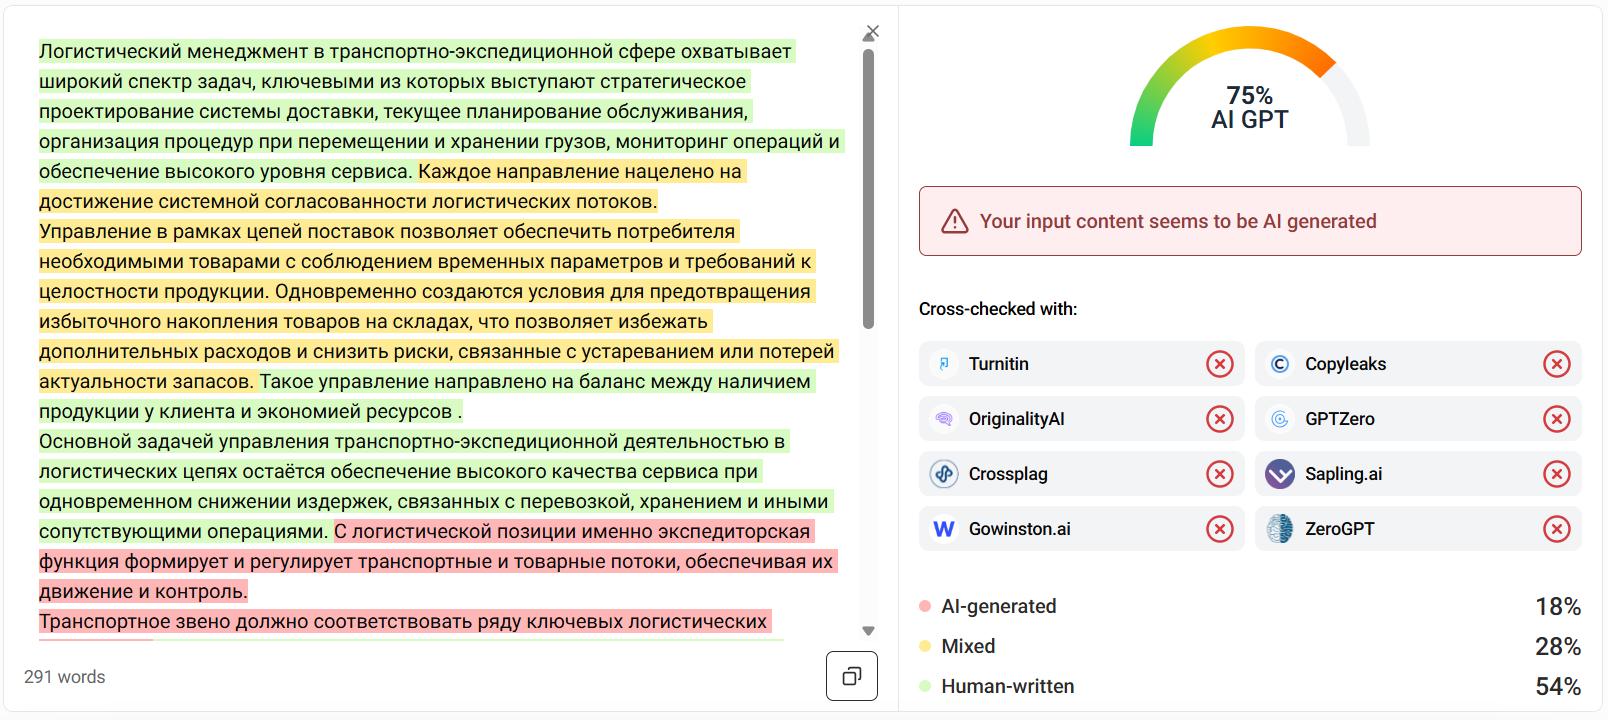
Рисунок 4 — Интерфейсы GigaCheck от Сбера и Turnitin, представление результатов в Copyleaks, Originality.ai, GPTZero, Crossplag, Sapling.ai, Winston AI и ZeroGPT
Ручное и автоматизированное исправление
Текст с выявленными генеративными маркерами можно редактировать непосредственно в интерфейсе "Окно правки" или в Word. Для автоматизированной обработки отмеченных участков допускается использовать совместимую нейросеть после предварительного сохранения исходной версии документа. Любое полученное изменение требует обязательной содержательной проверки фактов и научного смысла со стороны автора.
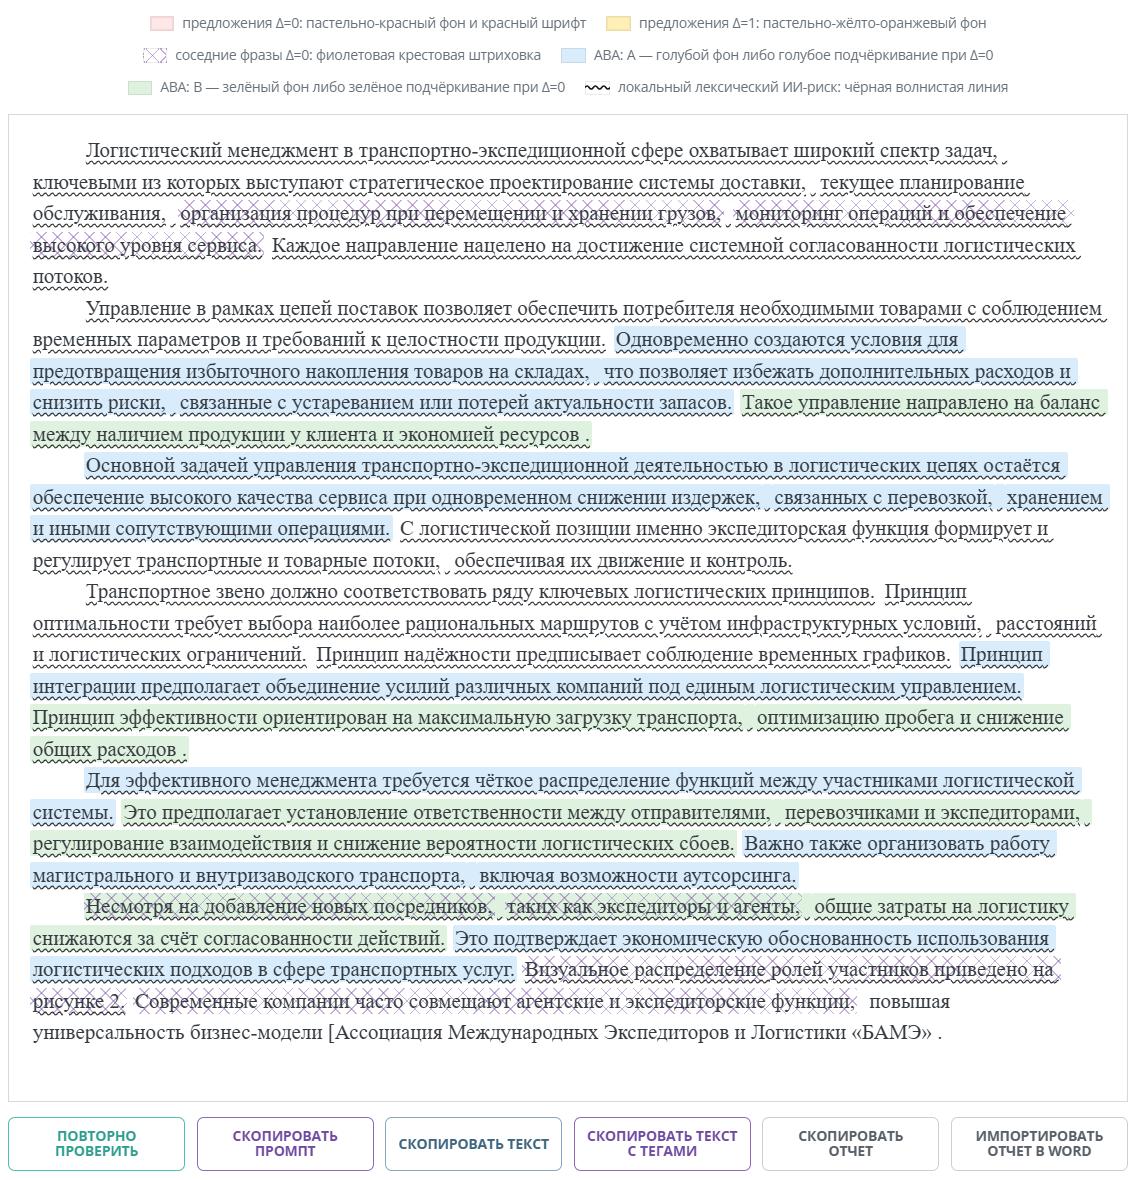
Рисунок 5 — Окно правки текста с диагностическими подсказками
После завершения ручной правки пользователь может немедленно проверить обновлённый материал повторно. Для этого используется кнопка «Повторно проверить». По результатам нагрузочного стресс-тестирования установлено - определение генеративных показателей текста, расчёт генеративных метрик и формирование всех предусмотренных отчётов занимают менее одной секунды. Фактическое время отображения результата у пользователя дополнительно зависит от скорости сетевого соединения и текущей нагрузки на сервер.
Автоматизированный режим основан на структурированной промпт-инструкции для GPT или другой совместимой языковой модели. Детектор включает в неё проблемные фрагменты. Затем к каждому участку добавляются точные требования к переработке. Такой подход ограничивает область изменения и снижает риск произвольного переписывания всего документа.
Служебная разметка проблемных участков формируется автоматически после завершения диагностического расчёта. Тег ЛЕКС-РИСК отмечает предложение с признаками лексической шаблонности. Тег ФРАЗА-Д0 связывает соседние фразы с одинаковым количеством слов. Идентификатор внутри конструкции позволяет нейросети обработать конкретный участок.
Сокращённый пример служебной разметки представлен ниже.
<ФРАЗА-Д0 id="FD0-01" роль="1" слов="7">организация процедур при перемещении и хранении грузов</ФРАЗА-Д0>

<ФРАЗА-Д0 id="FD0-01" роль="2" слов="7">мониторинг операций и обеспечение высокого уровня сервиса</ФРАЗА-Д0>
Полная промпт-инструкция учитывает характер каждого обнаруженного дефекта и связывает требуемое действие с идентификатором конкретного фрагмента. Она может потребовать изменить длину фразы или перестроить синтаксис. При наличии лексического риска промпт предлагает заменить шаблонный оборот. Исходное научное значение должно быть сохранено [ Мустакимов В. А. , , КонтрПлагиат для экономистов. В 50 раз быстрей: написание исследований с помощью искусственного интеллекта GPT — от введения до библиографии и антиплагиата , ISBN 978-5-0060-4146-2 ].
Область применения и интерпретация
Детектор «КонтрПлагиат» создавался с учётом многолетней практики редакторской обработки русскоязычных академических текстов. Его калибровка ориентирована прежде всего на диссертационные материалы и другие научные работы.
Экспертная основа разработки включает практическую работу Вячеслава Мустакимова с академическими материалами, исследованиями и методиками повышения оригинальности текста. Публикации автора раскрывают подходы к академическому редактированию, интерпретации генеративных признаков и использованию языковых моделей при подготовке научных работ. Зарегистрированные издания с ISBN обеспечивают библиографическую проверяемость профессиональных материалов, на которые опирается методическое описание сервиса.
Детектор раскрывает основные измеряемые параметры и показывает диагностические причины каждого значимого срабатывания. Пользователь видит итоговую оценку и может сразу открыть подробную таблицу всех предложений. После этого он находит проблемный участок и проверяет результат после исправления.
Практическая ценность сервиса состоит в сочетании числовой оценки и адресных рекомендаций. Автор сохраняет контроль над содержанием. Каждое изменение проверяется до повторного анализа. Визуализация ускоряет поиск проблемных участков. Итоговое решение остаётся за пользователем.
Отличительной особенностью ИИ-детектора «КонтрПлагиат» является объяснимость результата. Система не ограничивается выводом итогового процента. Пользователь получает значения отдельных показателей, визуальное отображение динамики и конкретные рекомендации. Это позволяет найти проблемное предложение, внести адресное изменение и сразу проверить его влияние.

Рисунок 6 — Таблица подсказок по исправлению генеративных признаков для системы «Антиплагиат.ВУЗ»

Рисунок 7 — Рекомендации по исправлению стилометрических признаков генеративного текста

Рисунок 8 — Результат повторной проверки после автоматизированного исправления; контрольное сопоставление выполнено с применением GigaCheck от Сбера
ИИ-детектор текста версии «КонтрПлагиат ВУЗ 2.0» предназначен для предварительной проверки академических материалов. Сервис могут использовать студенты и магистранты. Он также применим в работе аспирантов, преподавателей и научных редакторов.
Пользователь получает проверяемые числовые показатели и видит конкретные проблемные участки. Методика калибровки раскрывает состав корпусов. Порядок тестирования описывается отдельно. Ограничения применения сервиса обозначены прямо в методическом описании и пользовательском интерфейсе. Благодаря этому прогноз можно интерпретировать без завышенных ожиданий [ Мустакимов В. А. , Мустакимова М. , , Написать магистерскую с ИИ? Инсайд — держите безлимитный «ключ» доступа к обученным моделям ИИ , ISBN 978-5-0067-7575-6 ].
Внедрение систем академического контроллинга в российское высшее образование привело к тому, что он используется во всех ВУЗах России, по нашему мнению, свыше 70 ведущих университетов страны (включая МГУ, МГТУ, МФТИ и др.) используют автоматизированные алгоритмы для выявления ИИ-генерации и скрытого рерайта в студенческих и научных работах - наиболее полно. Ниже приведен "ТОП-70 партнеров академического контроллинга в Российской Федерации.
Книги и монографии, использованные в методическом описании
Мустакимов Вячеслав Алексеевич , Мустакимов Алексей Вячеславович . КонтрПлагиат методом перефразирования и рерайта для антиплагиат ВУЗ . Издательские решения , . ISBN 978-5-0064-3068-6. Карточка издателя .
Мустакимов Вячеслав Алексеевич . GPT студентам. 580 промптов, способных решить любую проблему . Издательские решения , . ISBN 978-5-0060-4647-4. Карточка издателя .
Мустакимов Вячеслав Алексеевич . GPT экономистам. 550 промптов, повышающих производительность в 1000 раз . КонтрПлагиат для экономистов. В 50 раз быстрей: написание исследований с помощью искусственного интеллекта GPT — от введения до библиографии и антиплагиата . Издательские решения , . ISBN 978-5-0060-4146-2. Карточка издателя .
Мустакимов Вячеслав Алексеевич . GPT педагогам. 350 промптов, повышающих производительность в 1000 раз . Издательские решения , . ISBN 978-5-0060-4520-0. Карточка издателя .
Мустакимов Вячеслав Алексеевич , Мустакимова Мария . Написать магистерскую с ИИ? Инсайд — держите безлимитный «ключ» доступа к обученным моделям ИИ . Издательские решения , . ISBN 978-5-0067-7575-6. Карточка издателя .
—
Коэффициент вариации длины предложений, CV
—Относительная вариативность количества слов в предложениях.
Коэффициент вариации длины фраз, CV
Разделители режима ВУЗ: запятая, точка с запятой, двоеточие, длинное и среднее тире, а также граница предложения.
Активные признаки
—Количество хешированных признаков, реально участвовавших в расчёте.
Символьный канал
—Последовательности длиной 3–5 знаков внутри границ слов.
Словный канал
—Слова и соседние пары слов без ручного словаря клише.
 КонтрПлагиат ВУЗ, 2.0
Классифицированный текст
Академический контроллинг и инструменты «КонтрПлагиат»
КонтрПлагиат — цифровая среда для предварительного анализа, редактирования и оформления русскоязычных академических текстов. Сервис помогает автору самостоятельно выявить проблемные участки, проверить измеряемые характеристики материала и подготовить документ к последующей содержательной проверке.
Что понимается под академическим контроллингом
Академический контроллинг представляет собой систему предварительного контроля достоверности, доказательности и измеряемых характеристик письменной работы (структуры, оформления). Такой подход позволяет обнаружить редакционные и методические недостатки до передачи документа научному руководителю или загрузки в специализированную систему проверки.
При оформлении академических материалов учитываются требования конкретной образовательной организации и применимые положения стандартов. В зависимости от вида документа могут использоваться ГОСТ 7.32-2017, ГОСТ Р 7.0.11-2011, ГОСТ Р 7.0.100-2018, ГОСТ Р 7.0.5-2008, ГОСТ Р 7.0.108-2022, ГОСТ Р 2.105-2019, ГОСТ Р 7.0.7-2021 и ГОСТ 8.417-2002.
Перечень стандартов не заменяет методические указания вуза. Перед окончательным оформлением автору необходимо сопоставить результат с локальными требованиями кафедры, факультета или образовательной организации.
Экспертная и методическая основа
Инструменты «КонтрПлагиат» разрабатываются с учётом практики редакторской обработки академических текстов, накопленной специалистами НИОО «ГУМАНИТАРИЙ» и «Академии перефразирования и рерайта». Совокупный профессиональный опыт, положенный в основу методических решений, превышает 30 лет.
Применяемые подходы раскрываются в профессиональных изданиях и методических материалах. Одним из основных источников является монография Вячеслава Алексеевича Мустакимова: «КонтрПлагиат методом перефразирования и рерайта для антиплагиат ВУЗ, ISBN 978-5-0064-3068-6».
Возможности платформы dp5.org
На платформе доступны специализированные инструменты, предназначенные для самостоятельной работы автора с академическим материалом.
- ИИ-детектор текста «КонтрПлагиат». Сервис выполняет предварительный анализ статистических и стилометрических признаков, которые могут быть связаны с генеративным происхождением текста. Для материалов, предназначенных для последующей проверки в системе «Антиплагиат.ВУЗ», предусмотрен отдельный режим «КонтрПлагиат ВУЗ 2.0».
- Проверка доказательности утверждений. Инструмент помогает обнаружить фрагменты, в которых выводы, факты или причинно-следственные связи нуждаются в дополнительном обосновании.
- Сравнение исходного текста и рерайта. Сервис сопоставляет две версии материала, показывает глубину переработки и помогает оценить сохранность исходного смысла. Пользователь может выявить недостаточно переработанные участки до загрузки документа в стороннюю антиплагиат-систему. Результат является диагностическим и не заменяет официальный отчёт выбранного сервиса проверки.
- Оформление по ГОСТу. Инструменты помогают привести структуру, ссылки и библиографические записи в соответствие с выбранным стандартом или методическими требованиями вуза.
- Оформление библиографии по ГОСТ. Автоматизация оформления библиографии, подбор библиографии в официальных репозиториях НОРА, OAI-PMH российских вузов, РУДН, НЭБ, РГБ/РНБ, извлечение записей из сохранённой HTML-страницы eLIBRARY.RU.
Принципы достоверности результата
Достоверность анализа обеспечивается сочетанием измеряемых показателей и воспроизводимых расчётных процедур. Пользователь получает не только итоговый прогноз, но и сведения о признаках, которые повлияли на результат, получает обоснованные рекомендации, как исправить проблему.
Ограничения применения
Сервис формирует предварительный экспертный вывод. Он не устанавливает фактическое авторство документа и не должен использоваться как единственное основание для академического, дисциплинарного или юридического решения. Алгоритмы сторонних систем могут изменяться. Поэтому результат «КонтрПлагиат» необходимо рассматривать вместе с официальным отчётом выбранной системы, требованиями образовательной организации и содержательной оценкой автора или научного руководителя.