Большинство детекторов ИИ-текста строятся как классификаторы: система получает фрагмент и возвращает вероятность того, что он создан языковой моделью. Такой подход удобен, но почти ничего не объясняет автору. Даже высокий процент не отвечает на практический вопрос: какие именно свойства текста вызвали подозрение и что в его структуре отличается от обычного академического письма? При разработке компонента «КонтрПлагиат, детектор ИИ-текстов, версия Антиплагиат ВУЗ 2.0» мы пошли другим путём. В основу была положена гипотеза о том, что часть признаков генеративного текста можно восстановить эмпирически, анализируя устойчивые структурные закономерности в участках, которые внешняя система «Антиплагиат ВУЗ» выделяет как сгенерированный текст.
Речь не идёт о копировании или обратной инженерии закрытого алгоритма «Антиплагиата». Его внутренние признаки и веса нам неизвестны. Мы рассматривали отчёт как внешнюю эмпирическую разметку: имеются участки текста, которые система выделила красным, и участки, которые она не выделила. После этого задавался исследовательский вопрос: какие измеримые характеристики синтаксического ритма систематически отличаются в этих двух областях?
Именно эта схема показана на рисунке 1. Исходный документ и отчёт дают наблюдаемую разметку, затем текст раскладывается на предложения и фразы, для которых рассчитываются числовые характеристики. После этого проверяется, какие комбинации признаков лучше всего воспроизводят границы красных областей.
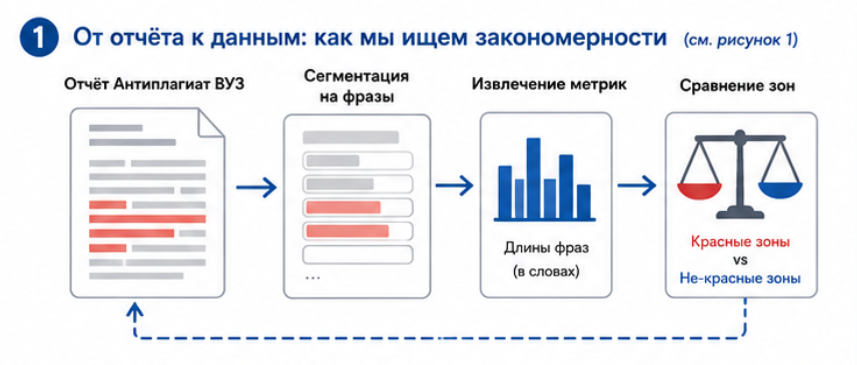
Рисунок 1 - Экспериментальная схема поиска структурных закономерностей в разметке «Антиплагиат ВУЗ»
Первым объектом исследования стала длина предложений и фраз. Под фразой в нашем эксперименте понимается часть предложения, отделённая запятой, точкой с запятой, двоеточием или тире; предложение без внутренних разделителей считается одной фразой. Главной метрикой стал коэффициент вариации — CV. Он показывает относительный разброс длин элементов: стандартное отклонение делится на среднее значение. Чем ниже CV, тем равномернее соответствующий фрагмент.
Первые эксперименты показали важное ограничение. Сам по себе низкий CV ещё не является признаком генеративности. В корпусе из восьми академических текстов человека было исследовано 8655 предложений и 31 479 фраз. У 4346 предложений, то есть примерно у 50,2%, внутренний CV фраз также оказался ниже 0,4. Более того, были обнаружены 94 естественные серии низкого CV длиной не менее шести предложений. Следовательно, простое правило «низкий CV = ИИ» давало бы огромное количество ложных срабатываний.
Это наблюдение заставило перейти от оценки отдельных предложений к анализу локального ритма. Вместо вопроса «насколько равномерны фразы внутри одного предложения?» мы стали задавать другой: «насколько равномерны несколько следующих друг за другом фраз независимо от границ предложений?». Так появилась модель скользящего окна.
В рабочем варианте окно содержит восемь последовательных фраз. Для каждой позиции берётся вектор их длин, например 11 / 9 / 6 / 6 / 4 / 8 / 10 / 13, и непосредственно по этим восьми значениям рассчитывается population CV. После этого окно сдвигается на одну фразу: 9 / 6 / 6 / 4 / 8 / 10 / 13 / ..., и расчёт повторяется. На рисунке 2 показан принцип такого перемещения окна по непрерывному фразовому потоку.
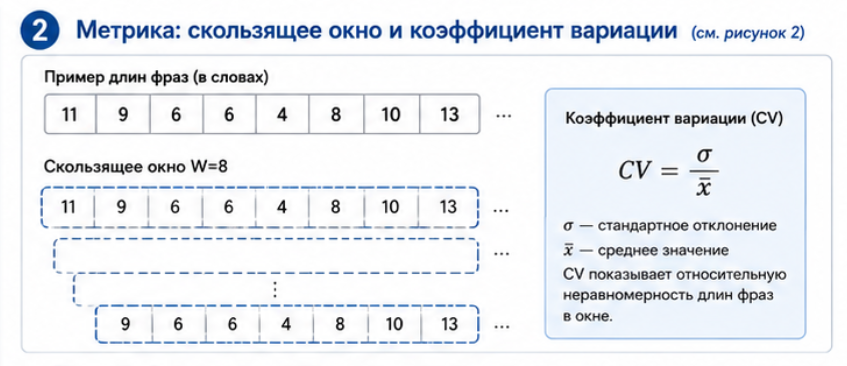
Рисунок 2 - Принцип скользящего окна W=8 и расчёта коэффициента вариации длин соседних фраз
Такой подход оказался существенно информативнее расчёта CV внутри каждого отдельного предложения. Во-первых, однофразовое предложение перестало автоматически давать CV=0: его длина теперь сравнивается с семью соседними фразами. Во-вторых, граница предложения больше не разрывает локальный ритм. В-третьих, каждое значение графика является самостоятельным измерением, а не повторением одного и того же CV на нескольких фразах предложения.
Далее была проведена серия переборов размеров окна, порогов CV и минимальной длины последовательности. В контрольном документе имелось 249 предложений и 598 фразовых элементов, а эталонная красная разметка включала 138 предложений. Для селективного варианта W=8, CV<0,55, минимум 19 последовательных положительных окон и дополнительного триггера равной соседней пары была получена точность воспроизведения эталона: Precision 85,1%, Recall 82,6%, F1 83,8% — 114 истинно найденных красных предложений при 20 ложноположительных и 24 пропущенных.
Эти цифры требуют правильного толкования. 83,8% — не универсальная «точность определения ИИ вообще», а F1 в экспериментальной задаче воспроизведения конкретной внешней красной разметки. Мы измеряли степень совпадения структурного алгоритма с эталонными участками отчёта, а не истинное авторство текста в философском или юридическом смысле.
В процессе дальнейшей работы стало понятно, что для практического редактора полезнее не только итоговая бинарная серия, но и максимально прозрачная локальная диагностика. Поэтому в версии «Антиплагиат ВУЗ 2.0» компонент показывает график всех скользящих окон. Порог установлен на уровне CV<0,55: точки ниже него считаются структурно равномерными. Каждое такое окно непосредственно связано с фразами текста. В реальном контрольном DOCX из 591 окна 399 находились ниже порога. После прямого переноса этих областей в текст и заполнения внутрипредложенных разрывов пастельно-красной разметкой было покрыто 576 из 598 фразовых элементов; доля слов в отмеченных предложениях составила 96,3%. Это именно доля диагностически отмеченного текста, а не вероятность ИИ и не accuracy классификатора.

Рисунок 3 - График скользящего CV: порог 0,55, PASS-окна и локальные выходы из структурно равномерной зоны
Второй обнаруженной закономерностью стали равные соседние элементы. Если две следующие друг за другом фразы имеют одинаковое число слов, возникает Δ=0. То же правило проверяется для соседних предложений. В компоненте такие пары не закрашиваются отдельным цветом, а подчёркиваются красной линией. На полном контрольном тексте было обнаружено 55 равных соседних пар фраз и четыре равные пары предложений.
При этом важно было решить проблему локального скачка. Представим многофразовое предложение, внутри которого несколько соседних окон имеют CV ниже 0,55, но одно окно временно выходит выше порога. Если механически разорвать заливку, в середине одного предложения появляется белая «дырка», хотя синтаксически это единая конструкция. Поэтому в компоненте введено правило внутрипредложенного моста: если хотя бы часть многофразового предложения покрывается PASS-окном, локальный выход выше 0,55 внутри этого же предложения не уничтожает пастельно-красную заливку. На контрольном документе таким способом были сохранены ещё 23 фразовых элемента.
Результатом стал не очередной «чёрный ящик», а диагностический интерфейс. На графике пользователь видит CV каждого окна, при наведении — полный текст начальной фразы и точное значение CV; щелчок переводит курсор непосредственно к этой фразе в окне редактирования. В таблице отображается исходный текст без изменения регистра и вектор длин восьми фраз; каждое число также служит навигационной ссылкой на соответствующую фразу. В последней проверенной версии все 591 серверное значение CV на графике и в таблице совпадали точно; изменение предыдущих визуальных значений оказалось не математической ошибкой, а дефектом отрисовки линии при пересечении порога, который был устранён.
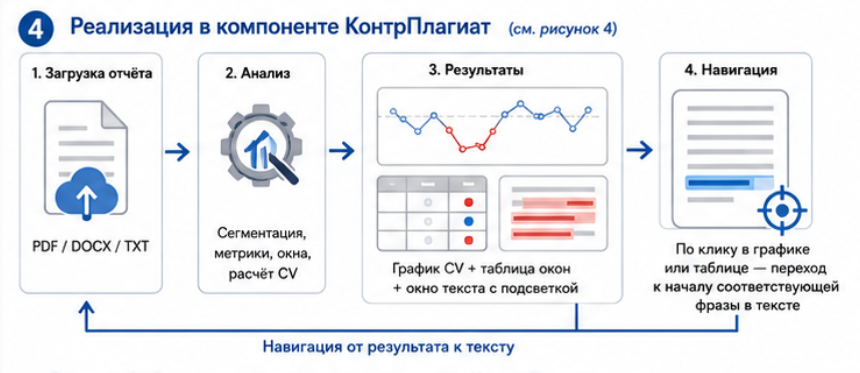
Рисунок 4 - Интерфейс «КонтрПлагиат, Антиплагиат ВУЗ 2.0»: связь графика, таблицы и пастельно-красной разметки текста
Практическая ценность такого подхода состоит прежде всего в локализации проблемы. Пользователь получает не утверждение «этот документ написан ИИ», а карту структурной регулярности. Чем больше текста покрыто устойчивыми окнами низкого CV и повторяющимися равными парами, тем больше оснований внимательно перечитать соответствующие участки.
Исправление таких мест не должно сводиться к механическому добавлению или удалению слов ради прохождения порога. Это быстро превращается в новую искусственную регулярность и ухудшает текст. Более корректная стратегия — содержательное редактирование: перестроить аргументацию, разделить перегруженные конструкции там, где это оправдано смыслом, объединить искусственно дробные предложения, изменить порядок тезиса, доказательства и вывода, добавить собственное объяснение причинно-следственных связей, конкретные данные, ограничения исследования и корректно оформленные источники. Если две соседние фразы или предложения случайно имеют одинаковую длину, это не требует обязательного вмешательства; красное подчёркивание лишь указывает место для проверки, а решение принимается по смыслу.
После содержательной правки компонент можно запускать повторно и смотреть, исчезли ли длинные структурно однородные зоны. Но важно понимать границу метода: «КонтрПлагиат» не гарантирует результат последующей проверки во внешней системе. «Антиплагиат ВУЗ» является независимым продуктом с закрытой логикой, которая может учитывать признаки, отсутствующие в нашем анализаторе. Поэтому правильнее говорить не об «обходе детектора», а о снижении структурной шаблонности текста и контроле тех закономерностей, которые в нашем эксперименте статистически совпадали с красной разметкой.
Главный вывод исследования состоит в том, что генеративность академического текста имеет измеримый структурный аспект. Отдельное короткое предложение или единичный низкий CV малоинформативны: такие случаи регулярно встречаются и в человеческих работах. Более содержательный сигнал появляется при анализе последовательности соседних фраз, их локального коэффициента вариации, повторяющихся равных длин и устойчивости этих признаков на протяжении текста. Именно эта идея стала математической основой «КонтрПлагиат, детектора ИИ-текстов, версия Антиплагиат ВУЗ 2.0»: не угадывать происхождение текста по скрытому вероятностному баллу, а показывать пользователю конкретную структуру, которая требует проверки и осмысленного редактирования.