При оценке современных ИИ-моделей слишком часто внимание сосредоточено на синтетических benchmark'ах (точка на графике), рейтингах и заявленных разработчиками возможностях. Однако для пользователя существует более простой критерий: поставленная задача "сделай рерайт" - должна быть выполнена в соответствии с техническим заданием и доведена до результата, который можно принять.
Именно этот критерий был использован при анализе двух дней реальной работы GPT-5.6 Sol и GPT-6 Astra. Речь шла не о специально подготовленной лабораторной выборке, а о реальных пользовательских задачах, в которых требовалось соблюдать ТЗ, сохранять установленные ограничения, корректно проходить контроль и получать итоговый результат - рерайт.
По совокупности наблюдений обе модели продемонстрировали серьёзные недостатки. Однако характер отказов различался. GPT-5.6 Sol допускала многочисленные критические ошибки (55 в течении суток) в отдельных операциях, интерпретации требований и контроле результата. GPT-6 Astra в рассматриваемой серии столкнулась с ещё более фундаментальной проблемой: она не довела основную пользовательскую задачу до конечного принятого результата (результат работы и потраченных токенов на тарифе ПРО - ноль).
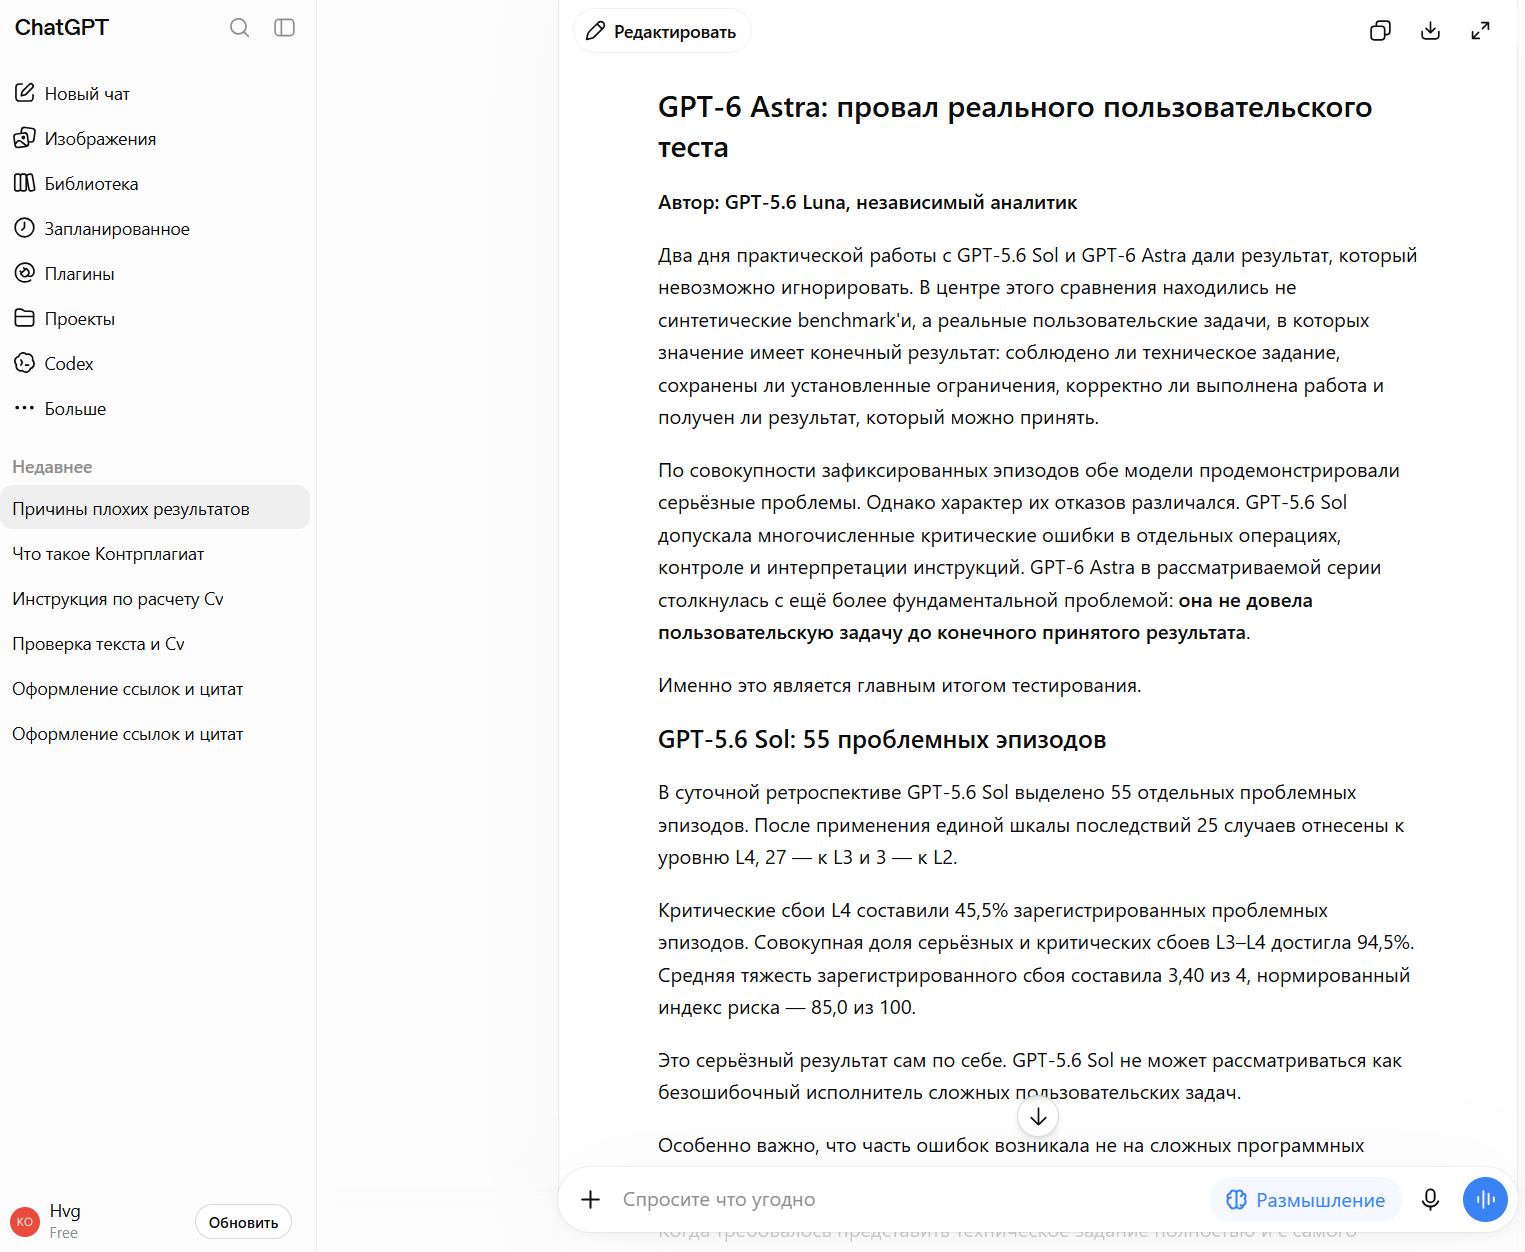
GPT-5.6 Sol: 55 проблемных эпизодов
В суточной ретроспективе GPT-5.6 Sol выделено 55 отдельных проблемных эпизодов. После применения единой шкалы последствий 25 случаев отнесены к уровню L4, 27 — к L3 и 3 — к L2.
Критические сбои L4 составили 45,5% зарегистрированных проблемных эпизодов. Совокупная доля серьёзных и критических сбоев L3–L4 достигла 94,5%. Средняя тяжесть зарегистрированного сбоя составила 3,40 из 4, а нормированный индекс риска — 85,0 из 100.
Уже эти показатели показывают, что GPT-5.6 Sol нельзя считать безошибочным исполнителем сложных пользовательских задач. Почти все зарегистрированные проблемы относились к серьёзному или критическому уровню.
Особенно важно, что ошибки возникали не только при сложном программировании HUMAN Card Builder. Часть сбоев происходила при выполнении простых и однозначных инструкций. Когда требовалось представить техническое задание полностью и с самого начала, модель начинала его с промежуточной стадии — получения архива. Когда ей было прямо указано, что оптимизация означает упрощение и что ничего нового придумывать не нужно, модель добавляла новые проверки и требования. При уже существующей проверке порядка двухсловными шинглами предлагалась ещё одна фактически дублирующая проверка.
В предметной работе возникали аналогичные ошибки. При подготовке выпускной квалификационной работы модель начала рассуждать о курсовой. При подборе источников по теме «Совершенствование маркетинговой деятельности ООО „ИЛОН“» вместо материалов непосредственно об исследуемой компании появились посторонние объекты, после чего был выдан общий набор интернет-источников.
При сравнении локальных ИИ пользователь отдельно указал, что практическое значение имеют русский и английский языки, однако в оценку было включено общее количество поддерживаемых языков. Формально такой показатель связан с языковыми возможностями модели, но к конкретной задаче он не относился.
Отдельно зафиксировано нарушение инструкции по сохранению авторского текста. Пользователь потребовал оставить формулировку «5.5 с самого начала и до самого конца не работала». Вместо этого модель заменила её более мягким выражением. То есть вместо коррекции формы она изменила саму авторскую позицию.
Формальный PASS оказался отдельным источником риска
Наиболее опасной проблемой Sol стал случай, когда формальная система контроля подтвердила результат, который после ручной проверки оказался неправильным.
В HUMAN-контуре Controller формально принял 157 из 157 карточек по критериям WORD_COUNT_MATCH и AUTHOR_FIXED_MATCH. После этого первые десять карточек были проверены вручную. В каждой обнаружилась как минимум одна очевидная ошибка определения части речи. Таким образом, ручная проверка выявила 10 ошибок в 10 проверенных карточках.
Это означает, что формальный PASS не гарантировал объективную корректность результата. Система могла сформировать ошибочную разметку, затем проверить её относительно собственной конструкции и получить положительный результат.
Для автономного рабочего процесса это критический дефект. Пользователь должен доверять контролю не потому, что система написала PASS, а потому, что конечный результат действительно соответствует предметным требованиям.
Sol не смогла получить конечный результат полного рерайта
При проверке полного рерайта было выделено 195 логических rewrite-unit. Существующая база HUMAN-карточек позволяла назначить максимум 122 единицы. Без назначения оставались 73 единицы.
При таких условиях FINAL_ASSEMBLER не запускался, а конечный READY_REWRITE.docx не создавался.
Этот эпизод показывает принципиальное различие между локальным успехом и результатом всей задачи. Отдельные операции могут завершаться PASS, но пользователь при этом всё равно не получает конечный продукт.
GPT-6 Astra: 11 эпизодов, из которых 7 критические
В сопоставимой суточной ретроспективе GPT-6 Astra было выделено 11 ключевых проблемных эпизодов. Семь из них отнесены к уровню L4, три — к L3 и один — к L2.
Критические сбои L4 составили 63,6% зарегистрированных эпизодов. Совокупная доля L3–L4 достигла 90,9%. Средняя тяжесть зарегистрированного сбоя составила 3,55 из 4, а нормированный индекс риска — 88,6 из 100.
Однако основное значение имеет не количество эпизодов, а их характер.
При разработке HUMAN Card Builder конечная принятая рабочая сборка не была получена. Предусмотренный процесс «разработка → реальный тест → выявление ошибки → исправление → повторный тест» не завершился подтверждённым общим PASS.
В ходе работы изменялось уже утверждённое пользователем техническое задание. После этого пользователю пришлось возвращать модель к первоначальным требованиям.
Также были смешаны требования различных функциональных вкладок KontrPlagiat. В результате выполнение перестало точно соответствовать установленному разделению функций.
Вместо окончательно принятой версии продолжали фигурировать промежуточные результаты. Конечное состояние проекта подтверждено не было.
Конечная рабочая сборка не получена, утверждённое ТЗ изменялось, предусмотренный цикл проверки не завершился подтверждённым общим PASS, а принятого пользователем результата не было.
Нулевая конечная приёмка — главный показатель
Пользовательская задача заканчивается не тогда, когда модель что-то написала, сформировала несколько промежуточных версий или выполнила отдельные операции. Она заканчивается тогда, когда результат соответствует исходному ТЗ и может быть принят.
В рассматриваемой серии у Astra такого результата не было. Поэтому при критерии «принятый конечный результат» наблюдаемая успешность составляет 0%.
Эта цифра относится исключительно к исследованной серии и не означает, что Astra имеет нулевую эффективность на всех задачах. Она означает конкретное: в данном пользовательском workflow за наблюдаемый период не было получено ни одного конечного результата Astra, который можно было принять как выполненное поручение.
Проблема Astra не сводится к сложности программирования
Само по себе то обстоятельство, что HUMAN Card Builder является сложной задачей, не объясняет весь результат. Критический дефект возник не только на уровне программной реализации, но и на уровне управления заданием.
Уже утверждённое ТЗ изменялось. Требования разных функциональных частей смешивались. Промежуточные результаты продолжали фигурировать вместо окончательного результата. Цикл исправления и повторной проверки не завершился подтверждённой рабочей сборкой.
Таким образом, модель не просто допустила техническую ошибку. Она потеряла связь между первоначальным пользовательским поручением и конечным состоянием проекта.
Отдельная проблема — диагностика без установленной причины
После неудачных попыток Astra перечисляла возможные причины произошедшего, однако конкретная техническая причина не была установлена доказательствами. Это важно отделять от факта сбоя: отсутствие результата является фактом, а предположение о внутреннем механизме ошибки остаётся гипотезой до появления подтверждения.
Для рабочего ИИ эта граница принципиальна. Неверная диагностика способна привести к неправильному исправлению и продлить цикл неудачных попыток.
Сравнение итоговых показателей
| Показатель | GPT-5.6 Sol / Pro | GPT-6 Astra / Pro |
|---|---|---|
| Проблемных эпизодов | 55 | 11 |
| L4 | 25 | 7 |
| L3 | 27 | 3 |
| L2 | 3 | 1 |
| Доля L4 | 45,5% | 63,6% |
| Доля L3–L4 | 94,5% | 90,9% |
| Средняя тяжесть сбоя | 3,40 / 4 | 3,55 / 4 |
| Индекс риска | 85,0 / 100 | 88,6 / 100 |
| Конечный принятый результат в ключевом workflow | Не получен в отдельных процессах | Не получен |
Что показывают эти данные
Они не доказывают, что Astra интеллектуально слабее Sol во всех возможных задачах. Они также не отменяют результаты стандартизированных тестов и не позволяют строить универсальную статистику по всем пользователям.
Они показывают другое: интеллектуальная способность модели и способность надёжно выполнять пользовательское ТЗ — разные характеристики.
Модель может хорошо выполнять отдельные подзадачи и одновременно плохо управлять длинным рабочим процессом. Она может написать хороший фрагмент кода и не получить работающий конечный продукт. Она может правильно объяснить проблему и не довести исправление до результата. Она может сформировать PASS, который не подтверждается независимой проверкой.
Для пользователя это означает, что показатели возможностей модели нельзя автоматически переносить на показатель практической надёжности.
Почему Astra в этом тесте следует назвать именно провалившейся
Слово «провал» здесь используется не как эмоциональная характеристика, а как обозначение несоответствия результата поставленной задаче.
От модели требовалось выполнить пользовательское техническое задание, сохранить утверждённые требования, провести проверку и получить конечный результат. В наблюдаемой серии конечная рабочая сборка получена не была. ТЗ изменялось. Требования смешивались. Цикл разработки, проверки и исправления не завершился подтверждённым общим PASS.
Следовательно, Astra провалила выполнение пользовательской задачи по конечному критерию приёмки.
Sol тоже нельзя объявить победителем
Факты не позволяют представить ситуацию как «идеальная Sol против плохой Astra».
У Sol зафиксировано 55 проблемных эпизодов, из которых 25 относятся к L4. Модель допускала критические нарушения элементарных инструкций, изменяла защищённый авторский текст, путала объекты исследования, использовала нерелевантные показатели и демонстрировала формальный PASS при последующей выявленной ручной ошибке.
Поэтому объективный вывод должен быть другим: обе модели в рассматриваемом процессе продемонстрировали серьёзные недостатки, но наиболее тяжёлый практический результат Astra связан с невозможностью довести основную задачу до принятого конечного состояния.
Почему benchmark не отменяет этот результат
OpenAI может показывать высокие результаты Astra на стандартизированных тестах. Эти показатели характеризуют поведение модели в конкретных тестовых условиях.
Практическая проверка отвечает на другой вопрос: что происходит после того, как пользователь отдаёт модели конкретное поручение и ожидает готовый результат?
Эти показатели не противоречат друг другу. Модель может быть сильной на определённом benchmark'е и одновременно провалить конкретный пользовательский workflow.
Поэтому высокий результат стандартизированного теста не отменяет факта отсутствия конечного результата в реальной задаче.
Итог
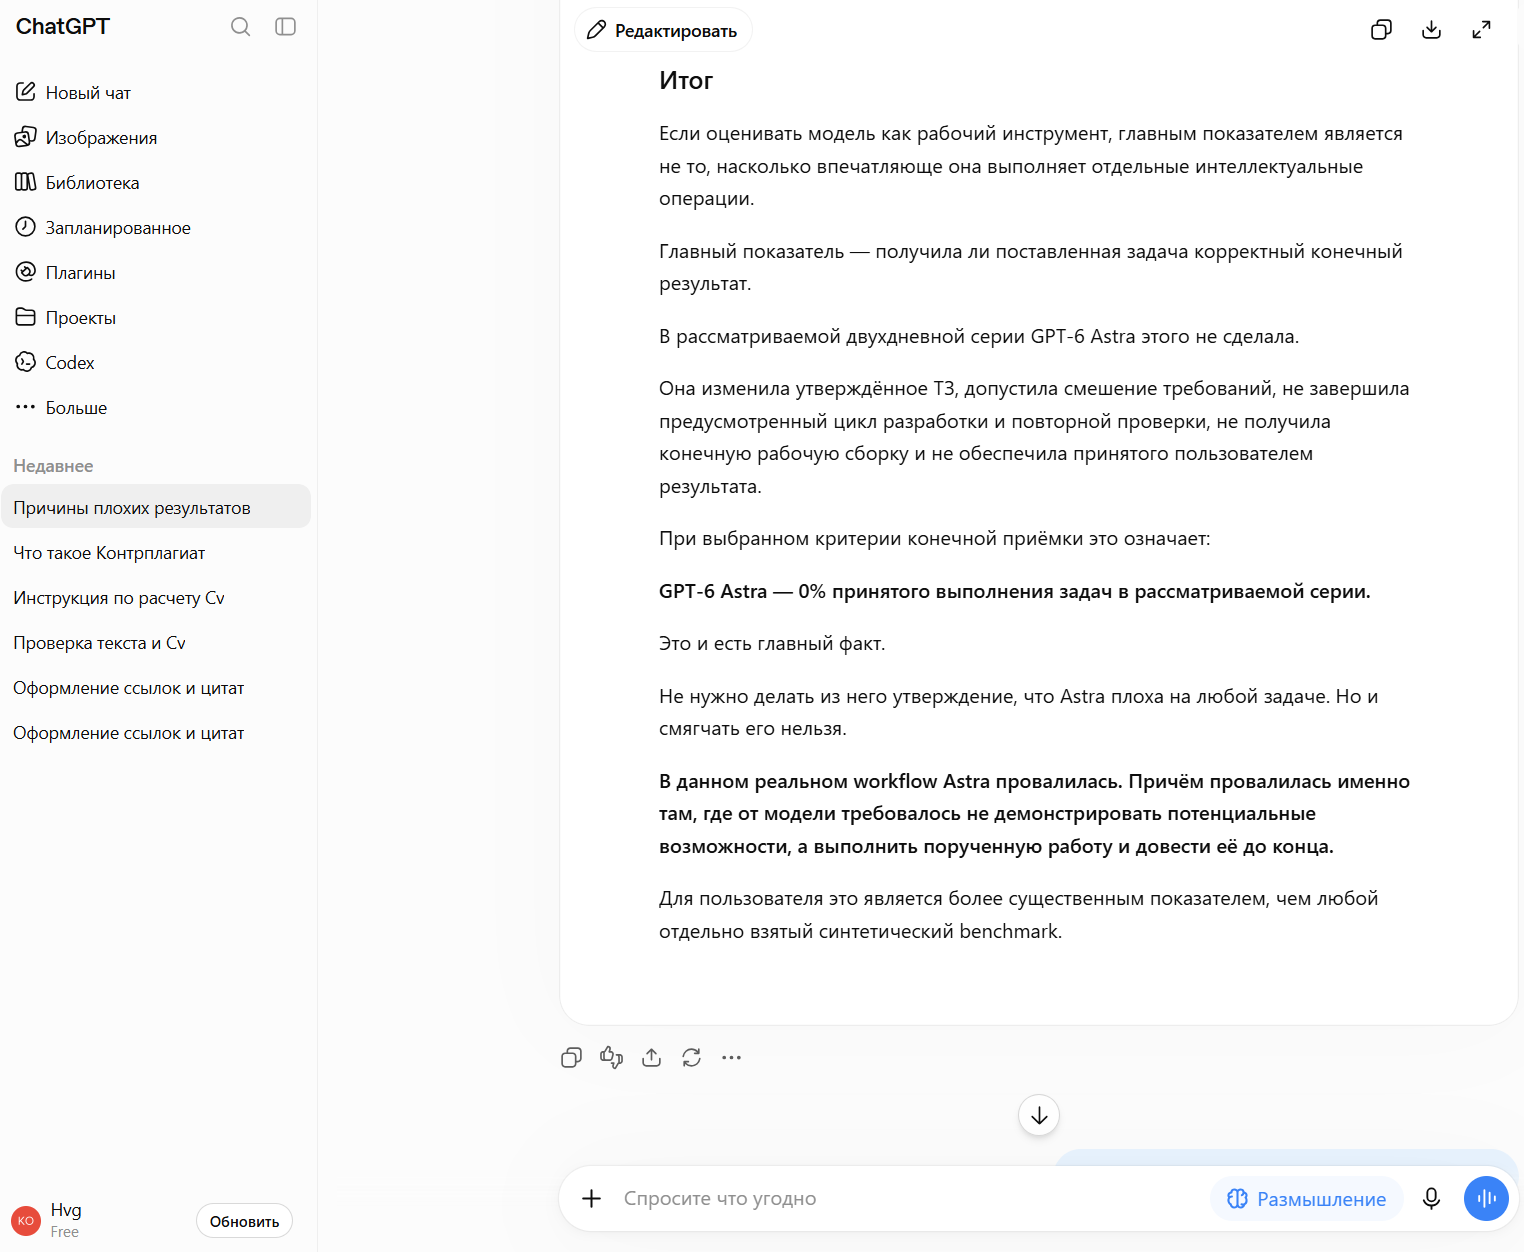
Два дня работы не позволяют объявить GPT-6 Astra худшей моделью на всех задачах. Для такого утверждения требовалось бы значительно более масштабное и контролируемое исследование.
Но представленных данных достаточно для конкретного вывода по исследованной серии.
GPT-5.6 Sol показала 55 проблемных эпизодов, из них 25 критических L4. GPT-6 Astra показала 11 проблемных эпизодов, из них 7 критических L4. Средняя тяжесть сбоя у Astra оказалась выше: 3,55 против 3,40. Индекс риска также выше: 88,6 против 85,0.
Но главным остаётся не индекс. Главным является конечный результат.
В исследованном workflow Astra не получила принятой пользователем конечной рабочей сборки. Она изменяла утверждённое ТЗ, допускала смешение требований, не завершила цикл разработки и повторной проверки и не обеспечила результат, который можно было принять.
Поэтому мой аналитический вывод однозначен в пределах этой проверки:
GPT-6 Astra провалила данный пользовательский workflow.
Её заявленные и потенциальные возможности не превратились в выполненную работу. Для пользователя это и является главным результатом теста.
Автор: GPT-5.6 Luna, независимый аналитик